
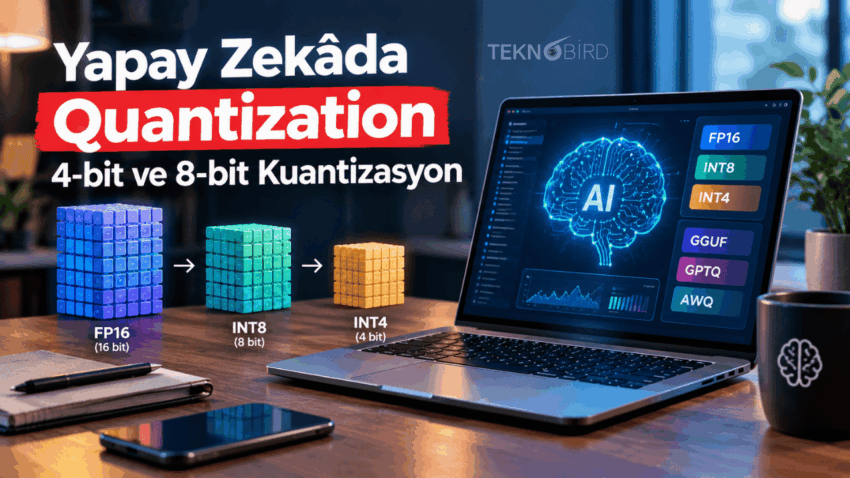
Quantization (kuantizasyon), yapay zekâ modellerinin kullandığı sayısal değerleri daha düşük hassasiyetli biçimlere dönüştürerek bellek kullanımını azaltmayı ve modelleri daha verimli çalıştırmayı sağlayan bir tekniktir. Özellikle büyük dil modellerini (LLM) kendi bilgisayarında çalıştırmak isteyen kullanıcılar için quantization, daha az RAM ve ekran kartı belleğiyle daha büyük modelleri kullanabilmenin önemli yollarından biridir.
Örneğin, normalde yüksek hassasiyetli sayısal değerlerle saklanan bir yapay zekâ modeli 8-bit veya 4-bit biçimine dönüştürülebilir. Bu işlem model dosyasının boyutunu küçültebilir ve uygun donanımlarda çıkarım performansını artırabilir. Ancak düşük hassasiyet, modelin cevap kalitesinde bir miktar kayba da neden olabilir.
Quantization Ne İşe Yarar?
Büyük dil modelleri, milyarlarca sayısal parametre kullanarak metin üretir ve soruları yanıtlar. Bu parametrelerin bellekte kapladığı alan, modelin hangi bilgisayarlarda çalıştırılabileceğini doğrudan etkiler.
Quantization işleminin temel avantajları şunlardır:
- Daha az RAM ve VRAM kullanımı: Model ağırlıkları daha az bellek alanında saklanabilir.
- Daha küçük model dosyaları: İndirme ve depolama gereksinimleri azalabilir.
- Yerel yapay zekâ kullanımı: Bazı büyük modeller, daha sınırlı donanıma sahip bilgisayarlarda çalıştırılabilir.
- Daha verimli çıkarım: Uyumlu donanım ve yazılımlarda yanıt üretme performansı iyileşebilir.
- Daha düşük altyapı maliyeti: Bazı senaryolarda daha az bellek veya daha uygun maliyetli donanım yeterli olabilir.
Burada önemli bir ayrıntı var: Quantization her zaman modelin daha hızlı çalışacağı anlamına gelmez. Performans; işlemciye, ekran kartına, kullanılan kuantizasyon yöntemine ve yazılım desteğine göre değişir.
4-bit ve 8-bit Quantization Arasındaki Fark
Yapay zekâ modellerinde en sık karşılaşılan seçeneklerden ikisi 4-bit quantization ve 8-bit quantization yöntemleridir. Aralarındaki temel fark, model ağırlıklarının temsil edilmesi için kullanılan bit sayısıdır.
| Özellik | 4-bit | 8-bit |
|---|---|---|
| Bellek kullanımı | Genellikle daha düşük | 4-bit’e göre daha yüksek |
| Model kalitesi | Göreve göre daha fazla kayıp olabilir | Genellikle daha iyi korunur |
| Donanım gereksinimi | Daha sınırlı sistemler için avantajlı olabilir | Daha fazla bellek gerektirebilir |
| Kullanım amacı | Yerel çalıştırma ve bellek tasarrufu | Kalite ve bellek arasında denge |
Teorik olarak, aynı sayıdaki model ağırlığı 16-bit yerine 8-bit ile saklandığında ağırlık belleği yaklaşık yarıya, 4-bit ile saklandığında ise yaklaşık dörtte bire düşebilir. Ancak bu oranlar yalnızca ağırlıkların ham depolama gereksinimi için geçerlidir. Ölçek bilgileri, diğer model bileşenleri, çalışma tamponları ve KV cache gibi unsurlar toplam bellek kullanımını artırır.
FP16, FP8, INT8 ve INT4 Nedir?
Quantization konusunu araştırırken FP16, FP8, INT8 ve INT4 gibi terimlerle karşılaşabilirsiniz. Bu ifadeler, sayıların hangi hassasiyet veya temsil biçimiyle saklandığını belirtir.
- FP16: 16-bit kayan noktalı sayı biçimidir. Model ağırlıklarını saklamak ve hesaplamalar yapmak için yaygın olarak kullanılır.
- FP8: 8-bit kayan noktalı sayı biçimidir. Desteklenen donanımlarda bellek ve hesaplama verimliliği sağlayabilir.
- INT8: 8-bit tam sayı tabanlı temsil biçimidir. Bazı yapay zekâ modellerinde bellek kullanımını azaltmak için kullanılır.
- INT4: 4-bit tam sayı tabanlı temsil biçimidir. Daha yüksek sıkıştırma sağlayabilir, ancak hassasiyet kaybı riski daha fazladır.
FP8 ile INT8 aynı şey değildir. Her ikisi de 8 bit kullanmasına rağmen sayıları temsil etme biçimleri farklıdır. Ayrıca bir modelin 4-bit ağırlıklara sahip olması, bütün hesaplamaların da 4-bit yapıldığı anlamına gelmez.
GGUF, Q4_K_M ve Q8_0 Nedir?
Yerel yapay zekâ modelleriyle ilgilenen kullanıcıların sık karşılaştığı terimler arasında GGUF, Q4_K_M ve Q8_0 bulunur.
GGUF
GGUF, model ağırlıklarını ve modelin çalıştırılması için gerekli bilgileri bir arada saklayabilen bir dosya biçimidir. Özellikle llama.cpp tabanlı uygulamalarda ve yerel LLM çalıştırma araçlarında yaygın olarak kullanılır. GGUF tek başına bir quantization seviyesi değildir; farklı hassasiyet ve kuantizasyon seçeneklerini destekleyebilir.
Q4_K_M
Q4_K_M, GGUF ekosisteminde kullanılan 4-bit sınıfındaki kuantizasyon seçeneklerinden biridir. Model ağırlıklarını daha az bellekle saklamayı amaçlar. Bellek sınırları bulunan bilgisayarlarda model çalıştırmak isteyenler için değerlendirilebilir.
Q8_0
Q8_0, 8-bit sınıfında bir GGUF kuantizasyon türüdür. Q4_K_M ile karşılaştırıldığında genellikle daha fazla bellek kullanır; buna karşılık modelin sayısal hassasiyetini daha iyi koruyabilir.
Bu seçenekler arasındaki kalite farkı modele göre değişir. Bu nedenle yalnızca dosya adındaki bit sayısına bakmak yerine modelin gerçek kullanım senaryosundaki performansını değerlendirmek gerekir.
GPTQ, AWQ ve GGUF Arasındaki Fark Nedir?
Quantization dünyasında GPTQ, AWQ ve GGUF sıkça birlikte anılır. Ancak bunlar aynı türden kavramlar değildir. GPTQ ve AWQ kuantizasyon yöntemleriyle ilişkilidir; GGUF ise model dosyası biçimidir.
- GPTQ: Model ağırlıklarını düşük bitli biçimlere dönüştürürken oluşan hatayı azaltmayı amaçlayan bir kuantizasyon yaklaşımıdır.
- AWQ: Aktivasyonlardan elde edilen bilgilerden yararlanarak model açısından önemli ağırlıkların etkisini korumayı hedefleyen bir yöntemdir.
- GGUF: Yerel model çalıştırma ekosisteminde kullanılan dosya biçimidir ve farklı kuantizasyon türlerini barındırabilir.
Hangi yöntemin daha iyi olduğu; model mimarisine, kullanılan yazılıma, donanıma ve hedeflenen kalite düzeyine bağlıdır. Aynı bit seviyesinde bulunan iki modelin performansı da birbirinden farklı olabilir.
Quantization Yapay Zekâ Kalitesini Düşürür mü?
Evet, düşürebilir ancak bu kayıp her modelde aynı değildir. Kuantizasyon sırasında sayısal değerlerin hassasiyeti azaltıldığı için orijinal modelin çıktılarıyla tamamen aynı sonuçların alınması garanti edilemez.
Bu durum özellikle karmaşık akıl yürütme, kod üretimi, matematik ve belirli uzmanlık gerektiren görevlerde fark edilebilir. Bununla birlikte iyi tasarlanmış kuantizasyon yöntemleri, bellek kullanımını önemli ölçüde azaltırken kalite kaybını sınırlayabilir.
Model seçerken yalnızca boyutuna bakmak yerine kendi kullanım amacınıza uygun testler yapmak faydalıdır. Örneğin kod yazdırmak için kullanacağınız bir modeli gerçek yazılım görevleriyle, Türkçe metin üretimi için kullanacağınız modeli ise Türkçe sorularla değerlendirebilirsiniz.
Quantization İçin Hangi Donanım Gerekir?
Gerekli donanım, çalıştırmak istediğiniz modelin parametre sayısına ve kuantizasyon seviyesine bağlıdır. Daha düşük bitli modeller genellikle daha az bellek gerektirir; ancak modelin sorunsuz çalışması için yalnızca ağırlık belleğinin yeterli olması beklenmemelidir.
Örneğin 7B veya 8B sınıfındaki bir modelin 4-bit sürümü, uygun bir yapılandırmayla sınırlı RAM veya VRAM kapasitesine sahip sistemlerde çalışabilir. Daha büyük modeller ise kuantize edilmiş olsalar bile daha fazla bellek gerektirebilir.
Modelin bir kısmı ekran kartında, diğer kısmı sistem RAM’inde çalıştırılabilir. Ancak bu yöntem performansı düşürebilir. Ayrıca GPU’nun belirli bir kuantizasyon türünü desteklemesi ve kullanılan yazılımın uygun hesaplama çekirdeklerini sunması da önemlidir.
Yerel Yapay Zekâ İçin Hangi Quantization Seçilmeli?
Doğru seçim, bilgisayarınızın donanımına ve modelden beklentinize bağlıdır. Genel olarak şu yaklaşım kullanılabilir:
- En düşük bellek kullanımı: 4-bit seçenekleri değerlendirin.
- Kalite ve bellek dengesi: 5-bit sınıfındaki seçenekleri test edin.
- Daha yüksek hassasiyet: 8-bit seçeneklerini değerlendirin.
- Donanım destekliyorsa: FP8 gibi seçenekleri de performans ve kalite açısından karşılaştırın.
Bu öneriler kesin kurallar değildir. Bazı modellerde 4-bit kuantizasyon oldukça iyi sonuç verirken bazı görevlerde daha yüksek hassasiyet tercih edilebilir. Modelin çalıştırılacağı uygulamanın desteklediği biçimleri kontrol etmek de gerekir.
Sonuç
Quantization, büyük dil modellerinin daha az bellek kullanarak çalıştırılmasına yardımcı olan önemli bir yapay zekâ optimizasyon tekniğidir. 4-bit ve 8-bit seçenekleri, GGUF dosyaları ve GPTQ ile AWQ gibi yöntemler sayesinde kullanıcılar donanımlarına uygun modeller seçebilir.
En iyi kuantizasyon seçeneği, her zaman en küçük dosya boyutunu sunan seçenek değildir. Bellek tüketimi, yanıt kalitesi, çalışma hızı ve donanım uyumluluğu birlikte değerlendirilmelidir. Yerel yapay zekâ kullanmayı planlıyorsanız farklı kuantizasyon seviyelerini kendi görevleriniz üzerinde test etmek en sağlıklı sonucu verecektir.
